AI FOR WORKFLOW
AI赋能提效
真实工作场景中的 AI 工作方法
我更关心的不是 AI 能生成什么,而是它能怎样进入真实工作。
01 / RESEARCH
资料搜集提效
7–14 DAYS → 4–5 DAYS
《言外之易》人物资料整理
A / 项目难点
项目难点
信息分散
跨平台搜集新闻、访谈与社交内容,避免遗漏关键经历。
检索量大
覆盖成长、作品、争议与历史表述,人工整理耗时。
事实需要交叉核验
比对原始来源、本人表述与时间线。
最终还要形成判断
提炼争议节点、导演组观点与采访切入点。
B / 核心工作流
GPT搭框架 → 多模型补搜 → 人工核验与判断
- STEP 01
GPT / 搭建研究框架
- 全网检索与人物时间线
- 建立章节结构
- 提出采访方向
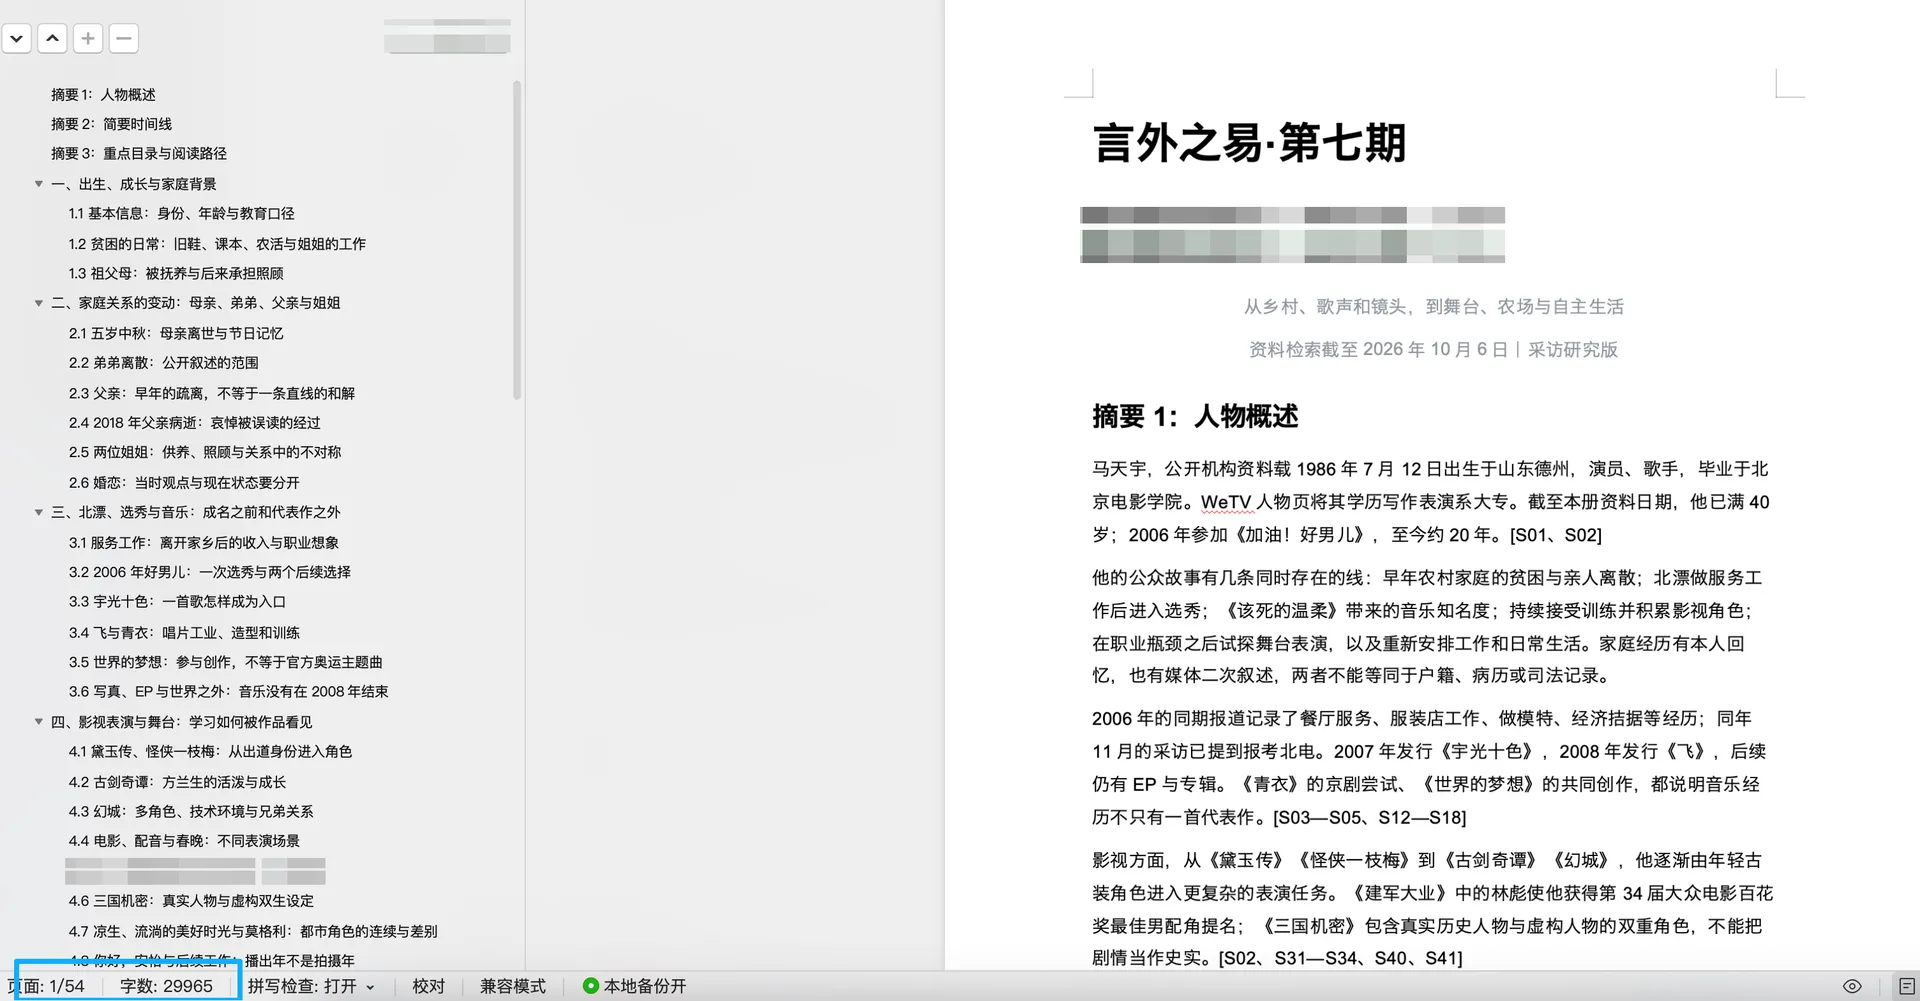
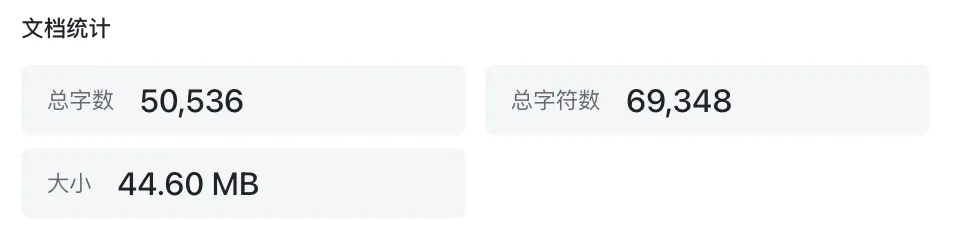
GPT初次生成约3w字文稿 - STEP 02
多模型交叉补搜
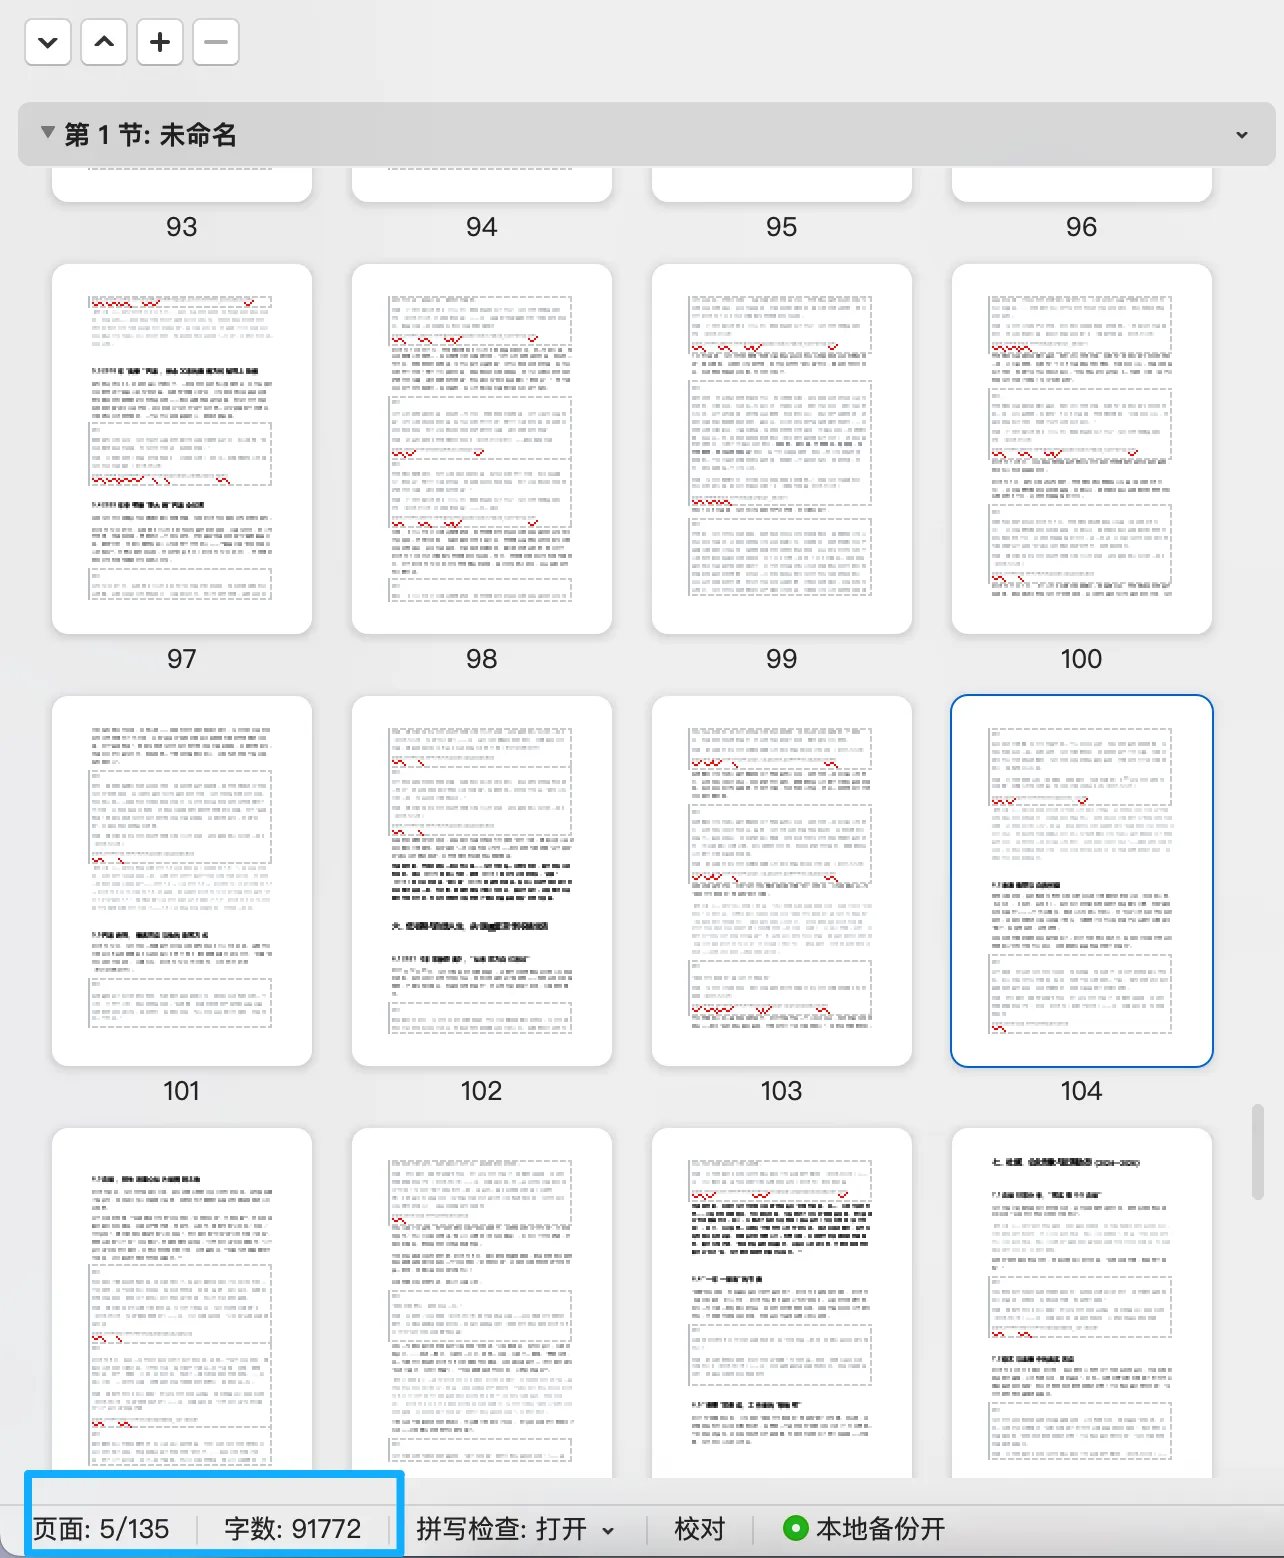
DeepSeek Harness补充版本 · 红色标注新增内容 DeepSeek / 千问 / 豆包 / 腾讯元宝 / 微博AI 等
- 豆包
- 抖音内容
- 腾讯元宝
- 微信公众号
- 微博AI
- 争议时间线与历史微博
- DeepSeek / 千问等
- 补充与交叉验证
- STEP 03
人工核验与判断
- 查原始来源
- 核对事实
- 信息去重
- 形成采访观点
C / 最终结果
人物研究周期明显缩短
7–14 DAYS4–5 DAYS
8期真实项目持续使用
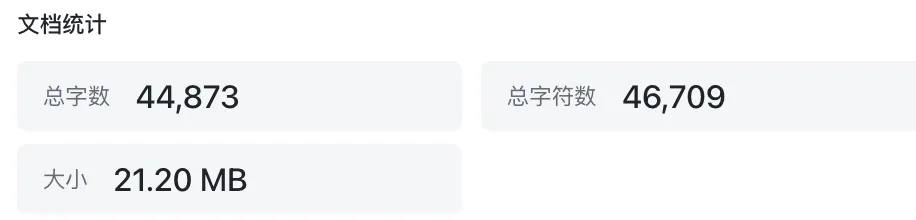
50,000+字 / 资料本示例
AI负责扩大检索范围和加快信息整理,
人的工作则从“找资料”转向“核验、判断与形成采访观点”。
02 / SUBTITLE SKILL
AI字幕审核 Skill
MANUAL → SKILL
从人工逐条校对,
到 AI + Python 半自动质检工作流
A / WHY
长时成片,紧张审核周期
3–5H 成片 × 10+ 字幕规范 × 紧张上线周期
《易立竞|言外之易》单期成片约3–5小时,需遵循10+条字幕规范。上线周期紧张,人工逐字校对耗时且易遗漏,因此将明确规则拆成可供导演组与后期使用的半自动审核机制。
B / AI边界判断
先判断 AI 的边界
- RULE-BASED
明确规则
Python
字数 / 空格 / 标点 / 时间码
- SEMANTIC
语义判断
AI
错别字 / 专有名词 / 断句
- UNCERTAIN
不确定项
Human Check
音频模糊 / 原意判断 / 最终修改
不确定项只标记,由人工复核与修改。
C / 方案设计
从规则,到一套可执行的审核机制
- RULE SCAN
Python规则扫描
机械扫描明确规则
- AI REVIEW
AI语义审核
结合上下文判断语义问题
- RISK FLAG
不确定项标记
无法确定的问题主动标记
- HUMAN CHECK
人工最终确认
人工完成最终确认
不直接修改原字幕,只输出问题报告。
D / 测试迭代
从第一版,到真实项目可用
- STEP 01V1
规则整理
10+条规范转为可执行规则。
- STEP 02TEST
边界测试
构造字幕错误,验证识别边界。
- STEP 03FIX
修正误判
作品名内标点转交 AI 复核。
- STEP 04REAL PROJECT
真实素材验证
3.5小时真实字幕,完整审核。
- STEP 05V2
二次迭代
发现文字漏检,增加 TEXT 2nd PASS。
误判案例 / V1 → FIX
V1《你好,李焕英》↓ 逗号被误判为“违规标点”
FIX调整判断问题依据→ AI结合作品名称复核
TEXT 2nd PASS / 文字专项复核错别字 · 的 / 地 / 得 · 单字问题 · 文字类明显错误
E / FINAL WORKFLOW
最终工作流
- 01SRT + AUDIO
字幕与对应音频
- 02PYTHON SCAN
确定性扫描
- 03AI SEMANTIC REVIEW
语义审核
- 04TEXT 2nd PASS
文字专项二次复核
- 05DEDUPLICATE & CLASSIFY
问题去重与分级
- 06ISSUE REPORT
生成字幕审核问题报告
- 07HUMAN CHECK
人工最终确认
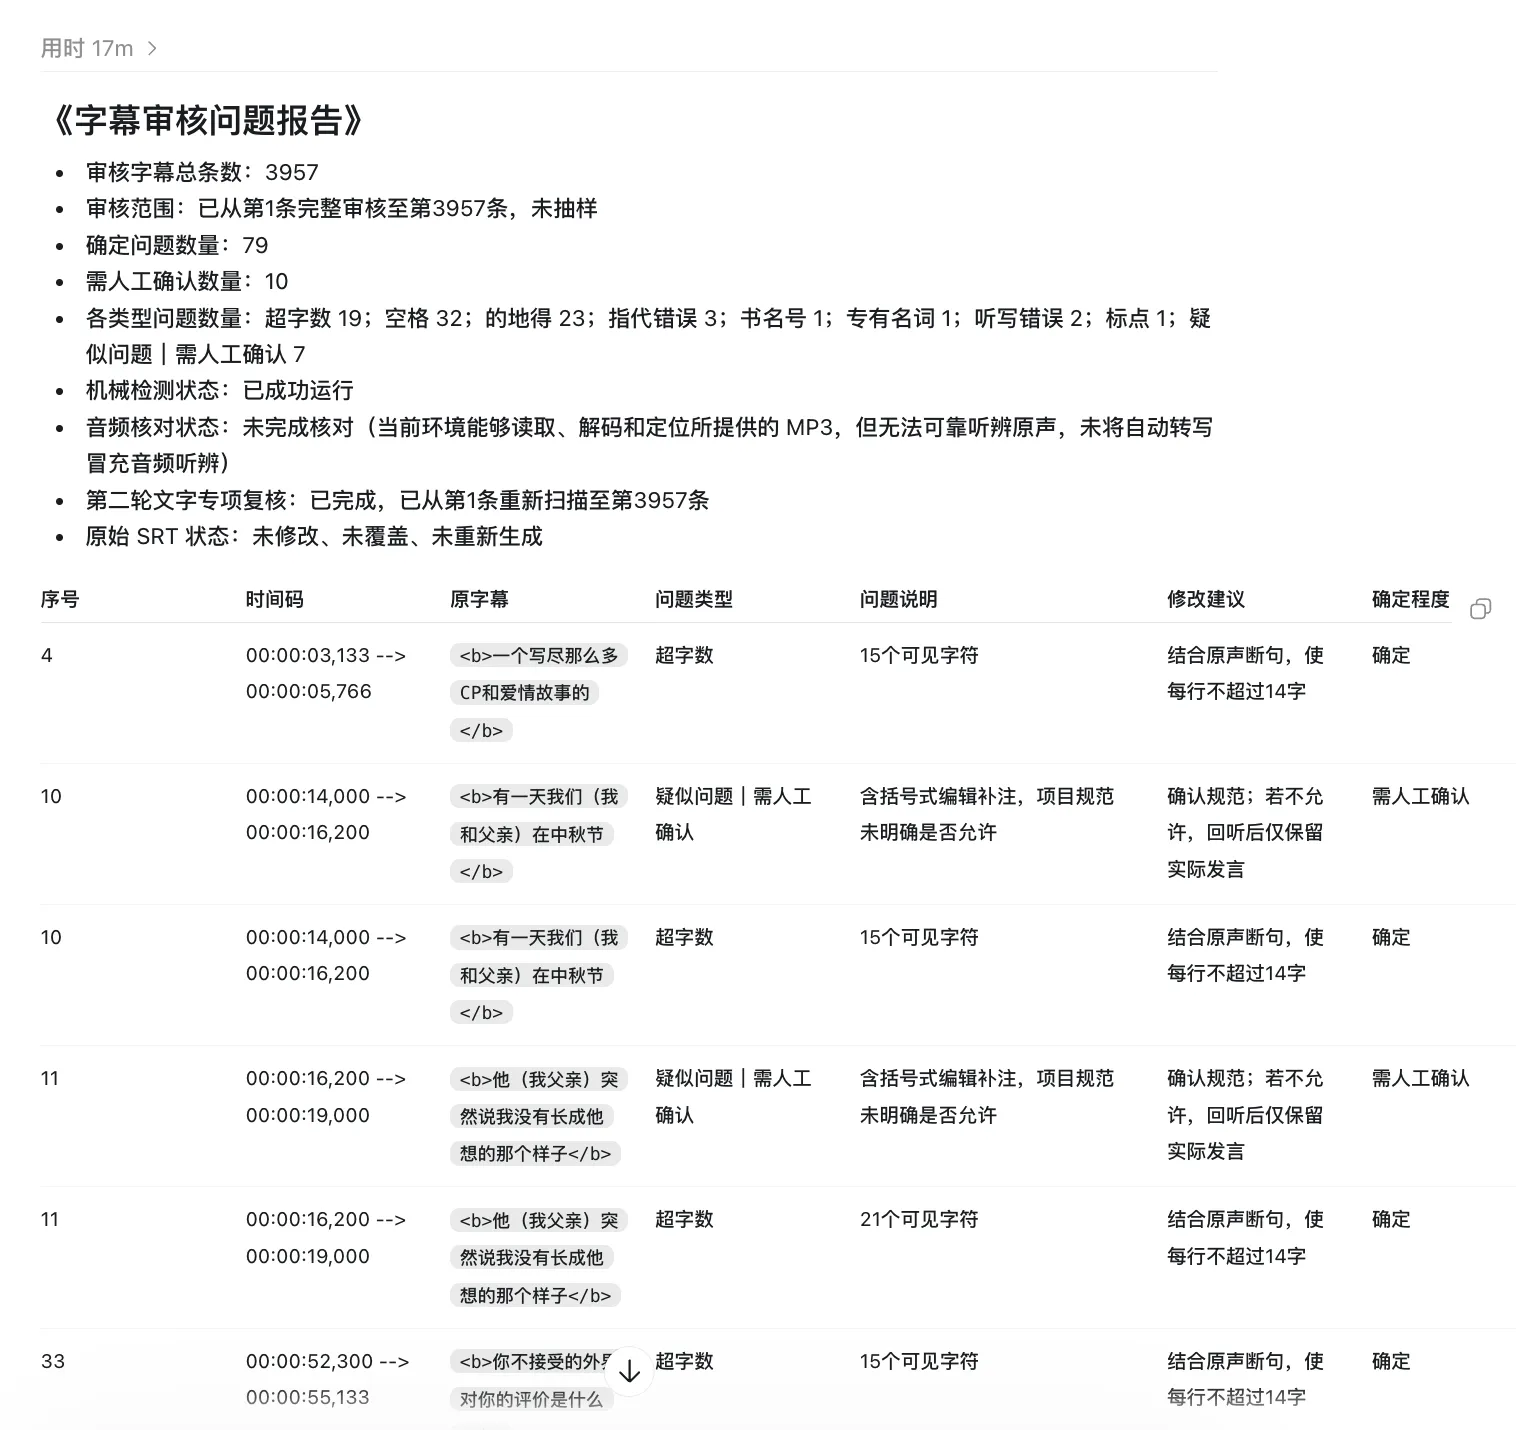
OUTPUT / 实际报告
字幕审核问题报告
项目复盘
用AI减轻重复性工作
注意判断AI在任务中的能力边界
03 / VISUAL PREVIS
AI视觉预演
TEXT → VISUAL
用AI把想法提前变成画面,辅助沟通与制作。
沟通参考
COMMUNICATION
氛围参考
MOOD / PREVIS